AI가 코드를 대부분 쓰는 지금, 코드베이스 건강을 어떻게 확인할까
2026.08.27
이 글의 차례
혼자서 노트 앱을 만들고 있다. 코드 대부분을 AI가 작성한다. 코드베이스는 점점 커져가는데, 모든 코드를 다 리뷰하기에는 무리가 있다고 생각했다. 그래서 코드베이스의 유지보수성, 확장성 같은 건강 상태가 나빠지고 있는지 알아챌 수 있는 방법이 필요했다.
코드베이스가 커져도, 변경 1회당 확신 비용이 오르지 않는다면 건강한 코드베이스를 갖고 있다고 볼 수 있다.
확신 비용은 기능 하나를 추가하거나 바꾼 뒤 제대로 됐다고 판단하기까지 드는 비용이다. 이 비용은 코드량과 분리할 수 있는 축이다. 코드가 10배가 돼도 변경 1회당 확인 비용은 그대로일 수 있다.
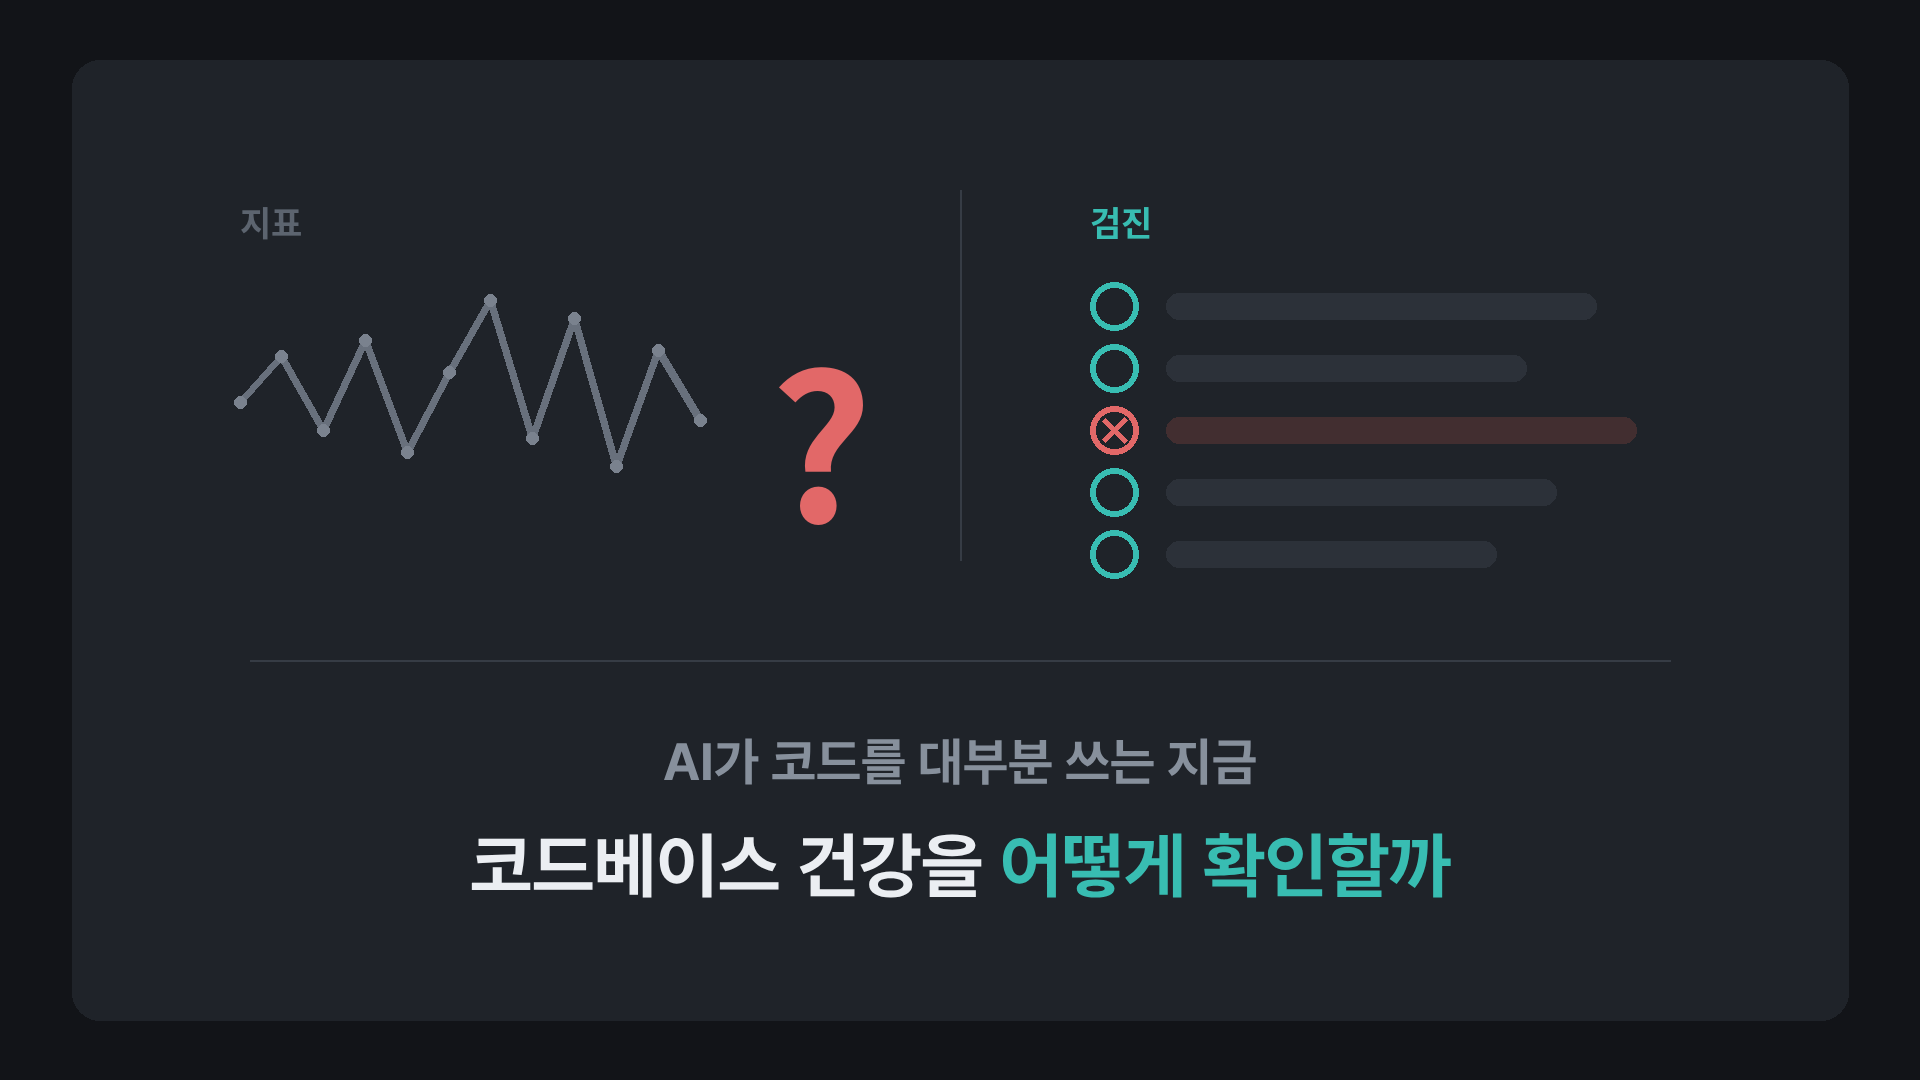
그럼 어떤 지표가 올라가거나 내려갈 때, 확신 비용이 늘어났는지, 줄어들었는지, 다시 말해 코드베이스의 건강 상태가 좋아졌는지 나빠졌는지 판단할 수 있을까?
결과적으로 말해서, 그런 지표는 못 찾았다. 절대 없다는 게 아니다. Svelte, TypeScript로 개발하며 Electron 기반 Desktop Markdown Application을 개발하는 내 코드베이스에서는 방법을 못 찾았다. 여러 시도를 해보았지만 모두 문제가 있었다.
하나의 지표를 찾으려던 시도
커밋당 검증 시간
첫 번째 후보는 커밋마다 검증에 쓴 시간이었다. 가장 직관적인 방법이다. 그 시간을 기록해 추세를 보고, 오르면 나빠지고 있다고 읽는다.
하지만 그 커밋에서 한 일의 난이도에 따라 검증 시간은 달라진다. 어려운 일을 해서 검증 시간이 오래 걸린 걸 코드베이스의 건강 척도로 삼을 수 없었다.
E2E 전수 실행 시간
두 번째 후보는 E2E 테스트 전체를 실행하는 시간이었다. E2E 테스트는 실제 앱을 띄워 사용자가 하듯 클릭하고 입력하는 검사다. 내 저장소에서 가장 오래 걸리는 검증이기도 하다.
이 값은 기능과 테스트가 늘면 자연스럽게 커진다. 측정 환경의 영향도 컸다. 2026년 8월의 유효한 실측은 29.6분에서 39.9분까지 10.3분 차이가 났다. 측정 중 컴퓨터가 잠자기에 들어가 테스트 하나가 17.8분으로 기록된 적도 있다. 다른 앱이 CPU를 90% 넘게 쓰는 상태에서 측정을 시작한 적도 두 번 있었다.
실행 시간이 늘어난 이유가 코드베이스의 악화인지, 정상적인 기능 증가인지, 컴퓨터 상태인지 이 값만으로는 구분할 수 없었다.
실패 원인 구성비
세 번째 후보는 실패한 테스트를 원인별로 분류한 비율이었다. 제품 결함, 제품 변경을 따라가지 못한 낡은 테스트, 실행마다 결과가 흔들리는 테스트로 나눈 뒤 제품 결함의 비율을 추적하려 했다.
하지만 실패 하나를 “제품 결함”으로 분류하려면 이미 그 원인을 다 조사한 상태여야 한다. 실제로 실패 28건을 분류하는 데 전수 실행 4회와 수십 건의 개별 조사가 들었다. 1인 개발자로서 현실적으로 관리하기 어려운 지표다.
셋의 공통점
셋 다 “비용”이라는 총량을 연속량 하나로 대신 재려는 시도였고, 각각 난이도, 정상 성장, 측정 환경, 측정 비용에 오염됐다.
확신 비용은 실재하는 비용이지만, 혈압처럼 잴 수 있는 값이 아니었다.
비용을 높이는 조건을 본다
질문을 바꿨다.
“비용이 얼마인가”를 재는 대신, “비용을 올리는 원인이 지금 남아 있는가”를 확인한다.
건강검진이 건강의 총량을 하나의 점수로 내놓지 않고 여러 위험 신호를 확인하는 것과 비슷하다. 검진 대상 목록이 완전하다고 보장할 수는 없지만, 이미 알고 있는 문제가 하나도 없는 상태와 여러 개 쌓인 상태는 구분할 수 있다. 그 구분이면 내 코드베이스의 건강 관리를 해야겠다는 판단을 하기에 충분하다.
이 관점으로 지난 넉 달을 다시 보니, 비용을 실제로 올렸던 원인들을 추릴 수 있었다. 그리고 각 검진 항목은 예/아니오로 답이 나오고, 코드 크기와 무관하며, 확인 비용이 정해져 있다.
건강검진은 매일 할 수 없지만, 코드베이스의 건강 상태를 확인하는 건 비용이 싸다면 매일 할 수 있다. 매일 뇌 MRI를 찍을 순 없지만, 간단한 혈당 체크는 자주 할 수 있듯이 말이다.
자기 전 혈당 체크를 하는 것을 코드베이스 건강 체크에 대입해보면, 커밋할 때마다 간단한 코드베이스 건강 상태를 체크하도록 하는 것이 된다. 그리고 그 체크는 사람이 하는 게 아니라 커밋 훅을 통해 기계적으로 수행되게 한다.
검진 항목은 다섯이다. 앞의 셋은 커밋할 때마다 돌아가는 혈당 체크에 해당하고, 넷째는 날을 잡아 받는 종합검진, 다섯째는 한 시점의 값이 아니라 쌓인 것을 보는 체성분 추이에 해당한다. 어떤 항목을 체크하도록 하였는지 설명하겠다.
검진 항목 1. 새 테스트가 거짓 초록을 만드는가
코드를 수정하고, 추가한 테스트 코드가 수정된 내용을 검증한다고 생각했지만 실제로 제대로 검증하지 못하는 테스트들이 있었다. 그래서 제품 동작을 일부러 깨뜨려 정말 그 테스트 코드가 실패하는지 보는 변형 검증을 강제하도록 했다.
테스트를 새로 쓰거나 수정한 커밋은 커밋 메시지에 변형 검증에 대한 내용을 작성하도록 하였고, 커밋 메시지에 그 내용이 없으면 커밋 훅이 막도록 했다. 그럼 실수로 변형 검증을 누락한 테스트 코드 변경은 커밋이 반려되어 변형 검증 작업을 수행하도록 했다.
검진 항목 2. 문서가 존재하지 않는 코드를 가리키는가
16만 줄에 달하는 내 코드베이스에는 AI가 코드를 빠르게 파악하고, 작업 방식을 알 수 있도록 도와주는 문서들이 있다. 토큰과 시간을 아끼고 작업 방식을 일정하게 유지하기 위함이다. 하지만 코드가 계속 추가되고 수정되는 과정 속에 문서가 따라가지 못하는 일이 발생한다. 문서 현행화가 제대로 되지 않는 것이다. AI가 지켜야 할 규칙과 검증 도구를 모아 둔 하네스에 문서 현행화를 강제 시켰음에도 제대로 지켜지지 않을 때가 있었고, 썩은 문서는 잘못된 길로 AI를 인도할 때가 있다.
이걸 방지하기 위해 문서가 지목한 파일이 실재하는지 확인하는 자동 검사를 만들었다. 커밋 훅이 린트, 타입 검사 등과 함께 매 커밋 그냥 돌리고 죽은 참조가 발견되면 커밋이 막힌다.
검진 항목 3. 새 테스트가 필요 이상으로 비싼 층에 놓였는가
처음 AI와 개발을 시작하면서, 코드 작성 비용이 급격하게 저렴해지는 것에 놀라워, 모든 테스트를 E2E로 수행했다. 가장 실사용에 가까운 환경에서 테스트하는 것이 정확하기 때문이다. 넉 달 후 전수 테스트가 40분씩 걸리는 상황이 됐다.
같은 동작도 어느 층에서 검사하느냐에 따라 비용이 달라진다. 함수나 컴포넌트만 실행하는 단위 테스트는 빠르다. 실제 앱을 시작하고 화면을 조작하는 E2E 테스트는 상대적으로 느리다. 운영체제나 프로세스 경계를 확인해야 하는 경우에는 E2E가 필요하지만, 함수의 입력과 출력만 확인한다면 단위 테스트로 충분하다.
새 테스트 파일을 만든 커밋에는 어떤 층에 두었고 왜 그 층이 필요한지 적는다. 층 판정: 기록이 없으면 커밋 훅이 커밋을 막는다. 강제되는 것은 판단의 옳음이 아니라 판단의 발생이다. 틀린 판정일 수는 있어도, 고민 없이 E2E 테스트가 쌓이는 것을 막아준다.
검진 항목 4. 현재 실패하는 테스트가 있는가
건강 관리에 비유하자면 앞의 세 항목은 허리 둘레 체크, 혈당 체크, 몸무게 체크와 같이 간단하고 빨리 끝나기 때문에 자주 할 수 있는 것이다. 그래서 커밋 훅을 통해 강제하도록 하였다.
하지만 우리가 1년에 한 번씩 시간을 내어 건강검진을 받듯이, 단위 테스트와 E2E 테스트를 포함한 전수 테스트를 돌려 빨간줄이 있는지 확인해야 한다.
모든 검증이 다 통과되는 상태면 제일 좋겠지만, 그게 아니라도 기준선을 잡을 수 있다. 예를 들어 300개의 테스트 중 3개 항목이 빨간색이고, 그 3개 항목을 인지하고 있는 상태에서 개발을 이어가는 것과, 모르고 이어가는 것의 차이다. 기준선이 있다면, 개발 과정에서 내 코드베이스가 더 나빠졌는지, 좋아졌는지, 유지되고 있는지 판단할 수 있다.
다만 수십 분이 소요되는 전수 테스트를 매 커밋 돌리게 할 수 없다. 이미 잘 동작하는 시스템을 유지보수하면서 CI/CD를 하는 것이라면 매번 전수를 돌리는 게 맞지만, 1인 개발자로서 제품을 만드는 과정 속에서 매번 전수 테스트를 할 수는 없다. (당연히 배포 직전에는 전수 테스트를 한다.)
그래서 전수 테스트를 해야 할 타이밍을 고민하게 했다. 내가 매번 고민하는 게 아니라, 커밋 훅이 나에게 고민할 때가 됐다는 걸 알려주게 했다. 커밋 훅이 매 커밋마다 마지막 전수 테스트 이후 소스 누적 변경량을 세고, 2만 줄을 넘으면 전수 테스트를 할 때가 됐다고 알려준다.
2만 줄이라는 기준은 실측에서 역산했다. 전수를 4개월 동안 한 번도 안 돌린 기간이 있었는데, 그 사이 소스가 111,393줄 바뀌었고 빨간줄이 28건 쌓여 있었다. 대략 4,000줄당 1건꼴이다. 2만 줄이면 빨간줄이 다섯 개쯤 쌓일 분량이고, 그 정도에서 한 번 보자는 뜻이다. 물론 이 값도 잠정이라 앞으로의 실측으로 보정해야 한다.
경고를 받았을 때 나는 전수 테스트를 돌릴 수도 있고, 유예할 수도 있다. 유예한다면 커밋 메시지에 그 이유를 적어야 커밋이 통과된다. 유예를 적으면 그 커밋이 새 기준점이 되어서 누적은 0부터 다시 세어진다. 계속 알람이 울려대면 사람은 알람을 꺼버리기 때문이다. 대신 미뤘다는 사실과 그 이유는 커밋 메시지에 남으니, 내가 전수를 몇 번이나 미뤘고 무슨 핑계를 댔는지는 git log 한 줄로 셀 수 있다.
검진 항목 5. 각 변경은 정당한데 합이 나빠지고 있는가
앞의 네 항목은 전부 검증 체계가 성한지를 본다. 테스트가 진짜인지, 문서가 안 썩었는지, 검증이 비싼 층에 쌓이는지, 빨간줄이 있는지. 그런데 이걸 다 통과하면서 코드가 나빠지는 길이 있다. 한글 입력을 처리하는 코드에 상태 플래그가 여덟 달에 걸쳐 열 개까지 늘어난 적이 있다. 버그 픽스 다섯 번이 쌓은 결과인데, 다섯 번 모두 수정 범위가 작았고 시키지 않은 리팩토링도 없었다. 하나씩 열어 보면 지적할 커밋이 없다. 이 문제는 커밋 하나만 보는 검사로 찾기 어렵다. 각 변경은 타당했지만 여러 변경을 합친 구조가 복잡해졌기 때문이다.
기계적으로 개수만 세는 방법도 충분하지 않았다. 구문 분석으로 가변 필드 후보를 뽑을 수는 있지만, 그 필드가 내부 상태인지 다른 객체에 작업을 맡기기 위해 보관한 참조인지는 코드를 읽어야 구분할 수 있었다.
그래서 이 항목만 검사 주체가 AI다. 제품 코드를 바꾼 커밋이 30개 쌓이면 알림이 뜨고, AI가 점검 목록을 들고 코드베이스를 훑은 뒤 결과를 커밋 메시지로 남긴다. 점검 목록이 찾는 것은 diff 하나로는 드러나지 않는 누적이다. 가변 상태가 늘고 있는가, 같은 로직이 두 벌이 됐는가, 예외 목록에 항목이 쌓이고 있는가 같은 것들이다. 앞의 넷과 달리 커밋을 막지 않는다. 이미 만들어진 커밋은 막을 수 없고, 이 항목의 목적은 막는 게 아니라 세는 것이다.
정리
매번 검진하기 위해선 기계적으로 판단할 수 있어야 하고, 그 판단 비용이 비싸면 안 된다. 오래 걸리면 우회하게 된다.
스크립트로 바로 확인할 수 있는 건 매 커밋마다 기계적으로 실행되도록 강제하고, 전수 테스트처럼 오래 걸리는 것은 기준을 정해놓고 판단을 하도록 강제한다. 그리고 코드를 읽어야 판단할 수 있는 것은 주기를 정해 모아서 본다.
커밋 메시지에 기록을 요구하는 장치는 거짓 기록을 막지 못한다. 또한 이 다섯 항목이 코드베이스 건강의 모든 원인을 다루는 것도 아니다. 예를 들어 필요한 코드를 찾는 탐색 비용은 여기서 확인하지 않는다.
현재 장치가 보장하는 범위는 정해진 질문을 빠뜨리지 않고, 실행하거나 미룬 판단을 기록으로 남기는 데까지다. 목록에 없는 비용 증가 원인은 실제로 겪었을 때 새 검사 항목으로 추가하여 보강해야 한다.