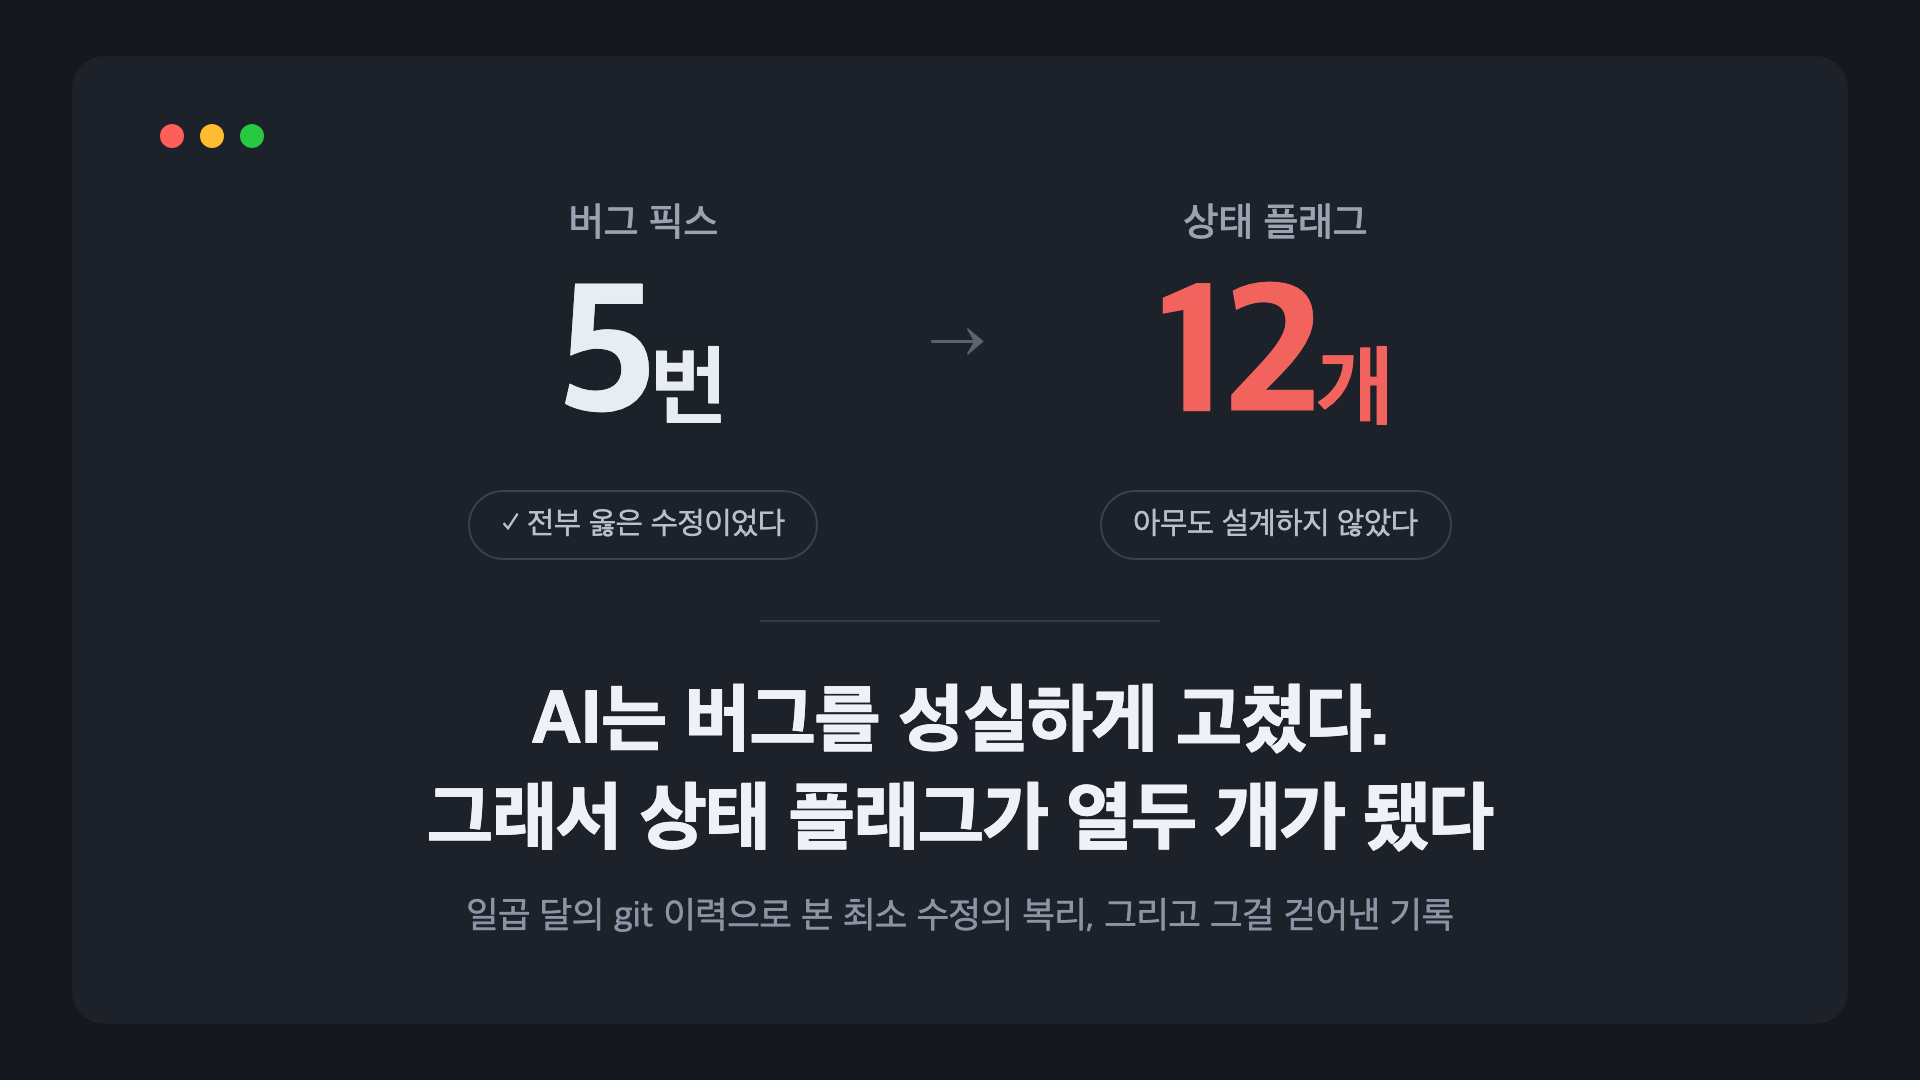
AI는 버그를 성실하게 고쳤다. 그래서 상태 플래그가 열 개가 됐다
2026.08.13
이 글의 차례
지난주, 직접 만들고 있는 에디터의 한글 입력 처리 코드를 리팩토링하려다가 이상한 걸 발견했다. 상태 필드 열 개가 파일 세 개에 흩어져 있었다. “지금 조합 중인가”, “미뤄 둔 키가 있는가”, “예약된 저장이 아직 유효한가” 같은 것들이다.
누가 이렇게 만들었는지 찾으려고 git 이력을 필드 하나하나까지 거슬러 올라갔다.
범인은 없었다.
여덟 달에 걸친 버그 픽스 다섯 번이 한 번에 많게는 네 개씩 보탰고, 하나하나는 전부 그 순간에 옳은 수정이었다. 그리고 그 수정의 대부분은 AI 에이전트가 썼다.
문제는 플래그가 많다는 것 자체가 아니었다. 각 버그를 고칠 때마다 수정의 범위는 잘 통제하고 있었다. 하지만 그 수정들이 몇 달 동안 쌓이면서 구조를 어떻게 바꾸고 있는지는 아무도 보고 있지 않았다.
이 글은 그 열 개가 어떤 문제를 풀려고 태어났는지, 왜 아무도 잘못하지 않았는데 이렇게 됐는지, 그리고 그 상태를 걷어내면서 알게 된 것에 대한 기록이다.
읽기 전에 알아 둘 전제는 세 가지다. 이 에디터는 브라우저 엔진 위에 올린 데스크톱 앱이고, 글을 줄 단위로 들고 있고, 사용자가 저장을 누르지 않아도 알아서 저장한다.
한글 입력 중에는 끼어들면 안 된다
영문 a는 키를 누르면 곧바로 a가 들어간다. 한글 한은 그렇지 않다. ㅎ → 하 → 한 세 단계를 거치고, 그동안 화면에 보이는 글자는 아직 확정되지 않은 임시 상태다. 이 구간을 조합(composition)이라 부르고, 브라우저는 시작과 끝을 이벤트로 알려 준다.
compositionstart          "지금부터 오는 건 임시다"
  beforeinput  ㅎ
  beforeinput  하
  beforeinput  한
compositionend            "한으로 확정한다"
문제는 이 구간에 에디터가 문서 구조(DOM)를 고치면 조합이 깨질 수 있다는 것이다. 글자가 사라지거나, 자음과 모음이 중복되거나, 커서가 튄다.
그렇다고 조합 중에 다른 요청이 멈추는 것은 아니다. Enter가 눌리고, Cmd+Z가 눌리고, 자동 저장이 돌 때가 된다. 즉시 처리하면 조합이 깨지고, 버리면 사용자의 의도가 사라진다.
남는 선택지는 하나다.
미뤄 뒀다가 조합이 끝나면 처리한다.
그리고 미룬 일은 어딘가에 기억해 둬야 한다.
처음에는 필드 두 개면 됐다.
플래그 둘이 열 개가 되기까지
2025년 9월.
한글을 조합하는 중에 Cmd+Z를 누르면 조합이 깨지는 버그가 났다.
수정은 단순했다. “지금 조합 중인가”라는 플래그를 하나 만들고, 되돌리기 진입점에 가드를 넣었다. 조합이 끝난 뒤 무엇을 실행해야 하는지도 기억해야 했으니 미뤄 둔 요청을 적는 필드가 하나 더 생겼다.
let composing = false
let deferred: 'undo' | 'redo' | null = null

function onCompositionStart() {
  composing = true
}

function undo() {
  if (composing) {
    deferred = 'undo'
    return
  }

  runUndo()
}

function onCompositionEnd() {
  composing = false

  if (deferred === 'undo') runUndo()
  if (deferred === 'redo') runRedo()

  deferred = null
}
필드 두 개와 진입점의 가드 하나. 영향 범위도 작고 이유도 명확했다.
2025년 12월.
이번에는 조합 중의 Enter였다.
되돌리기와 달리 Enter는 조합이 끝난 뒤 다시 발생시켜야 줄바꿈이 마저 처리된다. 그런데 키를 재생하기 시작하자 새로운 문제가 생겼다. 재생한 Enter와 브라우저가 원래 보내려던 Enter가 겹치면 줄이 두 번 나뉠 수 있고, 재생한 Enter가 다시 “조합 중이면 미룬다”는 가드에 걸리면 순환할 수도 있었다.
그래서 세 가지 상태가 더 생겼다.
-
미뤄 둔 이벤트
-
재생 직후 한 번 무시할 키
-
지금 재생 중인지 여부
2026년 3월.
글자가 하나도 들어오지 않고 끝나는 조합이 있다는 걸 알게 됐다.
“이번 조합에서 실제로 입력이 있었는가”라는 플래그가 추가됐다.
2026년 4월.
macOS의 Chromium에서는 조합 종료 이벤트 직후에도 최종 글자가 DOM에 아직 반영되지 않았을 수 있었다. 그래서 조합이 끝나자마자 저장하지 않고 한 프레임 기다려야 했다.
“잠깐 뒤에 실행”이 생기자 예약이 생겼고, 예약이 생기자 그 예약이 아직 최신인지 판정해야 했다.
조합 번호, 현재 조합의 번호, 지연 실행 예약, 예약을 구별하는 이름표가 한꺼번에 추가됐다.
2026년 5월.
이번에는 예약 자체에서 버그가 났다.
한글을 빠르게 이어 치면 낡은 예약이 새 입력을 옛 내용으로 덮어써 글자가 사라졌다.
이번 수정에서는 필드 개수는 늘지 않았다. 기존 예약 안에 무효화 표시 하나가 붙었을 뿐이다.
하지만 판단해야 할 것은 하나 더 늘었다.
여덟 달이 지나자 코드가 들고 있던 규칙은 이만큼이 됐다.
한글 입력을 위해 코드가 기억하던 규칙
조합 중의 되돌리기는 끝난 뒤 실행한다. 여러 번 눌리면 마지막 의도만 남긴다.
조합 중의 Enter는 끝난 뒤 재생한다.
재생 직후 브라우저가 보내는 같은 키는 한 번 무시한다.
재생 중에는 “조합 중이면 미룬다”는 규칙을 다시 적용하지 않는다.
입력이 없었던 조합은 끝나도 변환·저장하지 않는다.
조합이 끝나도 바로 저장하지 않고 한 프레임 기다린다.
각 조합을 구별한다.
지연 실행 예약을 서로 구별한다.
새 조합이 시작되면 같은 줄의 오래된 예약만 무효화한다.
더 나쁜 것은 이 상태들이 한 파일에 있지도 않았다는 점이다.
이 에디터의 입력 처리는 세 파일이 나눠 맡는다. 키 입력을 받는 키보드 핸들러, 글자 입력과 조합 이벤트를 받는 입력 핸들러, 그리고 저장과 되돌리기의 진입점인 에디터 본체다.
각 버그를 고칠 때마다 가장 가까운 곳에 필요한 상태를 추가했다.
조합 번호와 지연 실행 예약은 에디터 본체에, 미뤄 둔 키와 재생 관련 상태는 키보드 핸들러에, “입력이 있었는가”는 입력 핸들러에 있었다.
그리고 어느 순간부터 서로의 상태를 읽기 시작했다.
“지금 입력 처리 상태가 뭐냐”라는 질문 하나에 파일 세 개를 읽어야 답할 수 있었다.
어느 수정도 잘못이 없었다
위의 다섯 번의 수정을 하나씩 열어 봐도 비난할 곳이 없다.
버그 하나가 생긴다. 필요한 상태 하나를 추가한다. 진입점에 가드를 넣는다. 끝.
구조는 건드리지 않았다.
그럴 만한 이유도 있었다.
첫째, 이 영역은 재현이 비싸다. 한글 조합은 OS의 입력기가 만드는 이벤트 순서이고 타이밍이 곧 내용이다. 문제 하나를 확인하려면 실제 입력과 브라우저의 동작에 의존해야 했다.
둘째, 안전망이 부족한 상태에서 구조 변경은 위험하다. 단위 테스트가 하나도 없는 상태 덩어리를 버그 픽스 중 재설계하다가 깨뜨리면, 깨졌다는 사실을 알아차릴 방법도 마땅치 않다. 반면 플래그 하나와 가드 하나는 사람이 영향 범위를 확인할 수 있는 크기다.
셋째, 버그마다 묻는 질문이 달랐다.
처음에는 “조합 중인가”였지만, 다음에는 “이번 조합에서 실제 입력이 있었나”, 그다음에는 “이 예약이 아직 최신인가”, 다시 “같은 줄의 예약인가”가 됐다.
기존 상태로 답할 수 없는 질문이 생길 때마다 새 상태가 생겼다.
각각의 순간에는 그것이 최소 변경이었다.
그리고 이 수정의 대부분은 AI 에이전트가 했다.
에이전트의 시야는 대체로 현재 작업 단위에 맞춰져 있다. 몇 달 전 다른 세션에서 같은 영역에 플래그가 하나 추가됐다는 감각을 가지고 있지 않다. “이 버그를 최소 변경으로 고쳐라”라고 하면 그 요구에 맞게 고친다.
성실한 결과가 플래그 추가였다.
이 프로젝트에는 AI 에이전트를 위한 이런 규칙이 있다.
요청 범위를 넘는 수정은 하지 않는다. 필요하면 먼저 설명하고 승인받는다.
에이전트가 버그 하나를 고친다는 이유로 구조 전체를 조용히 뒤엎지 못하게 하려고 만든 규율이다.
이 규율은 제대로 작동했다.
매번 수정 범위는 작았다. 예상하지 않은 리팩토링도 없었다. 대신 플래그가 하나씩 조용히 쌓였다.
통제 장치는 각 수정의 폭발 반경을 줄였다. 누적은 그 장치의 관할이 아니었을 뿐이다.
문제는 최소 변경 원칙이 아니었다.
작은 수정들이 쌓이면서 상태 플래그가 얼마나 쌓이고 있는지 감시하는 장치가 없었다.
플래그 하나를 추가하는 비용은 해당 커밋만 보면 한두 줄이다. 하지만 그 상태를 읽고 판단해야 하는 자리는 기존 상태들과의 조합으로 늘어난다.
각 커밋만 보면 작은 변경이다. 몇 달 뒤 전체 구조에 무엇이 쌓였는지는 별도로 보지 않으면 드러나지 않는다.
열 개를 하나로 모았다
2026년 8월, 이 상태 묶음을 리팩토링했다.
걷어낸 것도 같은 AI와 함께였다. 달랐던 것은 도구가 아니라 질문이었다.
“이 버그를 고쳐라”가 아니라,
“이 상태 묶음에 소유자를 만들자.”
먼저 기존 동작을 고정하는 테스트를 붙였다. 구조를 바꾸기 전에 현재 동작을 기록해 두는 것이 필요했다.
그다음 세 파일에 흩어진 상태를 하나의 값으로 모으고, 모든 상태 변경이 함수 하나를 통과하게 만들었다.
function next(state, event) {
  // 사건에 따라 다음 상태를 계산한다.

  return {
    state: nextState,
    effects: [
      { do: 'replay-key', key: 'Enter' }
    ]
  }
}
이 함수는 저장하거나 키를 재생하지 않는다.
현재 상태와 방금 일어난 사건을 받아 다음 상태와 해야 할 일을 값으로 돌려준다. 실제 저장과 키 재생은 바깥에서 수행한다.
이제 “지금 입력 처리 상태가 뭐냐”라는 질문에는 한 곳이 답한다.
그런데 더 큰 변화는 따로 있었다.
시간이 값이 됐다
기존 버그의 상당수는 이런 식이었다.
-
빠르게 이어 치면?
-
저장이 실행되기 전에 새 조합이 시작되면?
-
그 새 조합이 다른 줄이라면?
전부 타이밍을 만들어야 재현할 수 있는 상황이었다.
상태와 사건을 값으로 바꾸자 타이밍을 직접 만들 필요가 없어졌다.
사건을 순서대로 적으면 그 자체가 시나리오가 됐다.
const state = replay([
  { type: 'composition-start', line: 'A' },
  { type: 'composition-end',   line: 'A' },
  { type: 'composition-start', line: 'B' }
])

expect(state.pendingSave).toEqual({
  line: 'A',
  id: 1,
  cancelled: false
})
이 테스트가 표현하는 상황은 이렇다.
줄 A의 조합이 끝나 저장이 예약됐다. 그런데 저장이 실행되기 전에 줄 B에서 새 조합이 시작됐다.
setTimeout도 없고, 실제 키 입력도 없고, 브라우저도 없다.
예전 테스트가 잡을 수 있었던 것은 주로 “글자가 사라졌다”는 결과였다.
이제는 “줄 B의 조합이 줄 A의 예약을 건드렸다” 같은 판단 자체를 테스트할 수 있다.
단위 테스트가 하나도 없던 자리에 56개가 생겼고, 전부 도는 데 153밀리초가 걸린다.
구조를 바꾸면서 코드의 총량은 오히려 늘었다. 대신 한 번에 이해해야 하는 범위는 줄었다.
수치로 보면 이렇게 바뀌었다.
| 착수 전 | 완료 후 | |
|---|---|---|
| 상태 필드 | 세 파일에 10개 | 하나의 상태 값 |
| 직접 대입하던 자리 | 35곳 | 1곳 (next() 내부) |
이 구조가 모든 문제를 해결한 것은 아니다.
next()에 대한 단위 테스트는 “이 순서로 사건이 들어오면 이렇게 판단한다”를 확인한다. 브라우저가 실제로 그 순서로 이벤트를 발생시키는지까지 증명하지는 않는다.
그래서 실제 브라우저에서 한글을 입력하는 테스트도 여전히 필요하다.
다만 역할이 달라졌다.
브라우저 테스트는 브라우저와 OS 사이의 연결을 확인하고, 상태 전이의 세부 규칙은 빠른 단위 테스트가 맡는다.
경계도 완전히 닫힌 것은 아니다. 실제 키보드 이벤트와 비동기 저장 작업처럼 바깥에 남아 있는 상태가 있고, 상태 스냅숏의 내부를 기술적으로 완전히 불변으로 만든 것도 아니다.
그리고 가장 중요한 것은, 동작 자체는 바꾸지 않았다는 점이다.
지난 여덟 달의 버그 픽스가 알아낸 규칙은 버릴 대상이 아니었다. 그것들은 사용자에게서 배운 값진 지식이었다.
문제는 그 지식이 플래그와 가드의 형태로 여기저기 흩어져 있었다는 것이다.
리팩토링은 그것들을 버린 것이 아니라 한곳에 모아 이름을 붙이고 테스트로 고정한 작업이었다.
최소 변경을 버리라는 얘기가 아니다
이력을 다시 봐도, 각 버그가 발생했을 때마다 구조 변경을 했어야 한다고 생각하지 않는다.
안전망 없는 상태 덩어리를 버그 픽스를 위해 재설계하는 것이 오히려 더 위험했을 수 있다.
최소 변경 원칙은 여전히 유효하다.
바뀌어야 하는 것은 누적을 감시하는 방법이다.
이번 사례에서 눈에 띄었던 숫자는 두 가지였다.
-
이 상태 묶음에 필드가 몇 개 있는가.
-
그 상태를 직접 읽거나 쓰는 자리가 얼마나 퍼져 있는가.
착수 시점에는 상태 필드가 열 개였고, 직접 값을 대입하는 곳은 서른다섯 곳이었다.
그런데 첫 번째 숫자만 봐서도 안 된다.
2026년 5월의 버그 픽스에서는 필드 수가 하나도 늘지 않았다. 기존 예약에 무효화 표시를 추가했을 뿐이다. 하지만 그 표시를 확인해야 하는 판단은 새로 생겼다.
개수보다 먼저 오는 신호도 있다.
상태의 소유자가 둘이 되는 순간.
서로의 상태를 읽기 시작하는 순간.
“지금 상태가 뭐냐”라는 질문에 답하기 위해 파일 두 개 이상을 열어야 하는 순간.
우리 코드에서는 2026년 4월에 이미 그 신호가 왔다. 세 파일이 상태를 나눠 들고 있었고, 지연 실행이라는 시간이 들어오면서 “어느 예약이 아직 유효한가”까지 추적하기 시작한 시점이다.
실제 리팩토링은 8월에 했다.
넉 달 늦었다.
AI가 최소 변경을 잘할수록 필요한 것
AI 에이전트와 일할수록 이런 누적을 따로 보는 일이 더 중요해진다.
버그를 고치는 에이전트는 눈앞의 문제를 해결하고 테스트를 통과시키는 데 집중한다. 그 작업 안에서는 최소 변경이 합리적이다.
하지만 “지난 몇 달 동안 이 영역에 비슷한 state가 몇 번 추가됐는가”, “언제부터 서로 다른 컴포넌트가 상대의 state를 읽기 시작했는가”는 다른 종류의 질문이다. 개별 버그 픽스만 봐서는 잘 드러나지 않는다.
이번 일을 겪고 나니, 에이전트에게 주는 규칙도 하나 더 추가할 수 있겠다는 생각이 들었다.
지금까지의 규칙은 이랬다.
요청 범위를 넘는 수정은 하지 않는다. 더 넓은 변경이 필요해 보이면 먼저 설명하고 승인받는다.
여기에 state를 추가할 때의 규칙을 더할 수 있다.
새 state field를 추가하기 전에 같은 기능을 다루거나 같은 lifecycle을 공유하는 기존 state가 있는지 먼저 확인한다.
기존 state와 함께 표현할 수 있다면 새 flag를 추가하지 않는다.
여러 state를 조합해야 현재 상태를 알 수 있거나, state ownership이 여러 컴포넌트로 퍼지기 시작했다면 하나의 owner로 모을 수 있는지 먼저 검토한다.
이번 리팩토링처럼 state와 event를 하나의 transition model로 모으는 것도 선택지 중 하나다.
이 규칙의 목적은 flag 추가를 금지하는 것이 아니다. 새 flag를 만들기 전에 “이미 같은 문제를 표현하는 state가 주변에 있지 않은가?”를 한 번 더 확인하게 만드는 것이다.
기존의 “최소 변경” 원칙을 버리는 것도 아니다. 무엇이 정말 최소 변경인지 결정하기 전에 현재 구조를 조금 더 넓게 보게 만드는 것이다.
Thoughtworks의 Birgitta Böckeler가 Harness Engineering을 설명할 때 사용하는 표현을 빌리면 이런 규칙은 guide에 해당한다. Agent가 코드를 바꾸기 전에 방향을 잡아 주는 장치다.[1]
그런데 guide만으로 충분할까.
이번 사례를 보면 그렇지 않은 것 같다. Guide가 있어도 놓칠 수 있고, 무엇보다 이번 문제는 한 번의 변경에서 생긴 것이 아니었다. 작은 변경 여러 개가 몇 달에 걸쳐 쌓이면서 만들어졌다.
그래서 그 결과를 따로 보는 sensor도 필요하다.
문제는 이걸 전부 deterministic하게 잡기는 어렵다는 것이다.
예를 들어 이런 검사는 만들 수 있다.
-
한 class나 module 안의 state field가 일정 개수를 넘으면 경고한다.
-
특정 state를 직접 변경하는 지점이 일정 개수를 넘으면 경고한다.
-
정해 둔 module boundary를 넘어 state를 읽거나 변경하면 실패시킨다.
이런 검사는 빠르고 결과도 일정하다. Harness Engineering의 구분으로는 computational sensor에 가깝다.[1]
하지만 state field가 다섯 개라는 사실 자체가 나쁜 설계를 뜻하지는 않는다.
반대로 field가 두 개뿐이어도, 그 의미를 알려면 다른 파일의 state까지 함께 읽어야 한다면 더 큰 문제가 이미 생겼을 수 있다.
이번 코드에서 실제로 문제가 된 것도 단순한 개수가 아니었다.
-
같은 concern에 속한 state가 계속 추가되고 있었고
-
state ownership이 세 파일로 퍼졌고
-
각 컴포넌트가 서로의 state를 읽기 시작했고
-
직접 state를 변경하는 지점이 35곳까지 늘어났다.
이 가운데 일부는 기계적으로 잡을 수 있다. Field 수, mutation site 수, dependency나 boundary violation 같은 것들이다.
하지만 이런 질문은 다르다.
이 flag들이 사실 하나의 state machine을 여러 조각으로 나눠 표현하고 있는 것은 아닌가?
이건 숫자만 세어서는 알기 어렵다. 각 state가 어떤 역할을 하는지, 어떤 lifecycle을 공유하는지, 어떤 조건에서 함께 변하는지까지 봐야 한다.
여기에는 LLM을 sensor로 쓸 수 있다.
예를 들어 같은 영역에 일정량의 변경이 쌓였거나 computational sensor가 신호를 냈을 때, agent에게 이런 점검을 시킬 수 있다.
최근 변경에서 같은 concern의 state가 반복해서 추가되고 있는가?
여러 flag가 사실 하나의 lifecycle이나 state machine을 표현하고 있지는 않은가?
State ownership이 여러 파일이나 컴포넌트로 퍼지고 있지는 않은가?
새 flag를 추가하는 대신 기존 state model에 합칠 수 있는 것은 없는가?
이런 검사는 static analysis처럼 답이 항상 같지는 않는다. 코드를 읽고 의미를 판단해야 한다.
Böckeler의 구분을 그대로 쓰면 inferential sensor다. Semantic analysis나 AI code review처럼 LLM의 판단을 이용하는 sensor다.[1]
중요한 것은 computational sensor와 inferential sensor 중 하나만 고르는 게 아니라는 점이다.
싸고 명확하게 잡을 수 있는 것은 computational sensor에 맡기고, 그걸로 판단하기 어려운 구조적 문제는 inferential sensor가 보게 할 수 있다.
실행 시점도 꼭 매 commit일 필요는 없다.
같은 영역에 변경이 일정 횟수 이상 쌓였을 때 실행할 수도 있고, computational sensor의 수치가 임계치에 가까워졌을 때 실행할 수도 있다. 아니면 일주일에 한 번처럼 정기적으로 codebase를 훑게 할 수도 있다.
Böckeler가 maintainability sensor를 실제로 실험한 후속 글에서도 sensor를 coding session과 CI에서만 돌리는 것이 아니라, 시간이 지나며 쌓이는 drift를 찾기 위해 반복적으로 실행하는 방식을 따로 다룬다.[2]
내 사례라면 다음과 같은 장치를 둘 수 있다.
첫째, 기존의 guide는 그대로 둔다.
요청 범위를 넘는 수정은 하지 않는다.
둘째, state를 추가하기 전 한 번 더 주변을 보게 하는 guide를 더한다.
같은 concern과 lifecycle의 기존 state를 먼저 찾고, 합칠 수 있는지 확인한다.
셋째, 개별 변경 바깥에서 누적을 보는 sensor를 둔다.
State 수와 mutation site 같은 값은 computational sensor로 계속 보고, 필요하면 LLM이 ownership과 state model 전체를 다시 검토한다.
돌이켜 보면 부족했던 것은 “AI가 버그를 더 잘 고치게 만드는 규칙”만은 아니었다.
AI는 이미 버그를 잘 고치고 있었다. 최소 변경이라는 guide도 잘 따르고 있었다.
문제는 잘 고친 작은 수정들이 몇 달 뒤 무엇이 되었는지를 다시 보는 loop가 없었다는 것이다.
최소 변경은 한 번의 변경을 안전하게 만든다.
하지만 작은 변경이 계속 쌓인 뒤에도 시스템이 단순하게 남는다는 보장은 없다.
그래서 AI에게 어떻게 변경할지를 가르치는 것만큼, 그 변경들이 결국 무엇을 만들고 있는지 다시 보게 하는 장치도 필요하다.
참고
[1] Birgitta Böckeler, Harness engineering for coding agent users, MartinFowler.com, 2026.
https://martinfowler.com/articles/harness-engineering.html
[2] Birgitta Böckeler, Maintainability sensors for coding agents, MartinFowler.com, 2026.
https://martinfowler.com/articles/sensors-for-coding-agents.html